Zahlen, die lügen, während sie die Wahrheit sagen
Beweise und Statistiken lesen
Eine Statistik kann völlig korrekt sein und dich trotzdem täuschen. Jede Zahl in einer Schlagzeile, einer Studie, einem Dashboard oder einem automatisierten Bericht hat einen Satz von Entscheidungen durchlaufen, bevor sie bei dir ankam. Jemand hat ein Maß, eine Stichprobe, einen Bereich und eine Achse ausgewählt.
Die Fähigkeit, die du heute aufbaust, liest alle vier: das Maß (welcher Durchschnitt), die Streuung (wie stark die Daten variieren), die Stichprobe (wer gezählt wurde) und die Achse (wie das Diagramm es darstellt).
Wenn diese Entscheidungen ungeprüft bleiben, erzählen korrekte Zahlen eine falsche Geschichte. Wenn du sie hinterfragst, siehst du, was die Daten tatsächlich aussagen.
Eine Zahl, der du nur halb vertraut hast
Bevor wir beginnen, denke an eine Statistik, auf die du gestoßen bist.
Drei Durchschnittswerte, drei Geschichten
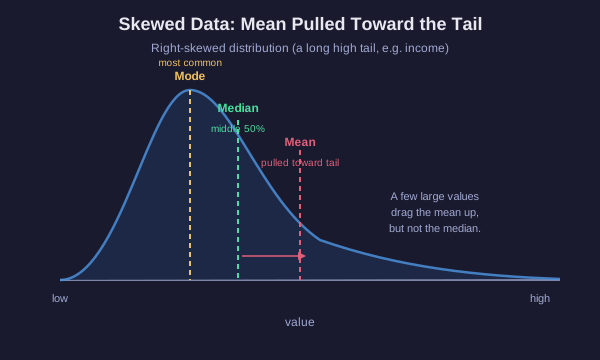
Das Wort „Durchschnitt“ verdeckt eine Wahl
Drei verschiedene Maße werden alle als Durchschnitt bezeichnet. Sie weichen in der Regel voneinander ab, und die Lücke zwischen ihnen ist Information.
- Mittelwert: Addiere jeden Wert und teile durch die Anzahl. Empfindlich gegenüber jeder Zahl, daher zieht ein einzelner Extremwert ihn mit.
- Median: Sortiere die Werte und nimm den mittleren. Die Hälfte der Daten liegt darüber, die Hälfte darunter. Ein Ausreißer verschiebt ihn kaum.
- Modalwert: Der Wert, der am häufigsten auftritt. Nützlich für Kategorien und zum Finden des typischen Falls in einer ungleichmäßigen Verteilung.
Wann jeder einzelne irreführend ist
Betrachte sieben Haushalte mit Einkommen in Tausendern: 30, 32, 35, 38, 40, 42 und einer mit 250.
Der Durchschnittswert liegt bei etwa 67k, aber sechs von sieben Haushalten verdienen weniger als das. Der einzelne Wert von 250k zog den Durchschnitt über fast alle anderen hinaus. Der Median liegt bei 38k, ist die wahre Mitte und beschreibt einen typischen Haushalt viel besser.
Dies ist die klassische Einkommensfalle. Berichtet man den Durchschnittswert, wirkt eine schief verteilte Gruppe reicher, als sie tatsächlich ist. Berichtet man den Median, sieht man die Mitte.
Die Regel: Bei schief verteilten Daten oder Daten mit Ausreißern erzählt der Median die ehrliche Geschichte. Bei annähernd symmetrischen Daten ohne Extreme stimmen Durchschnittswert und Median fast überein, und beide sind geeignet.
Wähle die ehrliche Kennzahl
Deine Aufgabe
Eine Stadt berichtet, dass ihr „durchschnittlicher“ Hauspreis 900k beträgt. Du erfährst, dass die meisten Häuser zwischen 250k und 400k verkauft wurden, aber drei Villen für jeweils über 6 Millionen verkauft wurden.
Berechne es selbst
Ein kleiner Datensatz
Sieben Mitarbeiter eines Startups verdienen diese Jahresgehälter, in Tausendern:
40, 42, 45, 48, 50, 55 und der Gründer mit 400.
Berechne beide Maße der zentralen Tendenz und entscheide dann, auf welches sich ein Stellensuchender verlassen sollte, wenn er sich ein typisches Gehalt hier vorstellt.
Gleicher Durchschnitt, verschiedene Welten
Ein Durchschnitt verdeckt die Streuung
Zwei Datensätze können denselben Mittelwert aufweisen und dabei völlig unterschiedliche Realitäten beschreiben. Der Durchschnitt sagt nichts darüber aus, wie stark die Werte streuen.
Testergebnisse der Klasse A: 78, 80, 82, 80, 80. Mittelwert 80, alle Werte eng beieinander.
Testergebnisse der Klasse B: 40, 100, 60, 100, 100. Mittelwert 80, aber die Ergebnisse schwanken stark von mangelhaft bis perfekt.
Gleicher Mittelwert von 80. Eine Klasse ist einheitlich, die andere ist gespalten in Schwächere und Besten. Ein Bericht, der besagt, dass beide Klassen „im Durchschnitt 80“ erreichten, tilgt diesen Unterschied aus.
Die Streuung, gemessen durch Spannweite oder Standardabweichung, zeigt, wie stark die Werte um den Mittelwert variieren. Durchschnittswerte ohne Streuung sind nur ein halber Satz. Frage immer, wie breit die Daten streuen.
Die Stichprobe ist das Argument
Kleine Stichproben sind verrauscht; verzerrte Stichproben sind falsch
Eine Statistik beschreibt nur die Personen, die gemessen wurden. Wenn die Stichprobe klein oder nicht repräsentativ ist, sagt die Zahl wenig über die breitere Welt aus, egal wie präzise sie aussieht.
- Stichprobengröße: Kleine Stichproben schwanken zufällig stark. Wirft man eine faire Münze 4 Mal, ist 100 % Kopf häufig; wirft man sie 4.000 Mal, pendelt sich das Ergebnis um die 50 % ein. Eine „40 % Verbesserung“ aus 10 Personen ist größtenteils Rauschen.
- Repräsentativität: Eine Umfrage in einem einzigen Stadtviertel, einer einzigen Altersgruppe oder unter den Nutzern einer einzigen Website kann nicht für alle sprechen. Die Stichprobe muss die Population spiegeln, die man beschreiben möchte.
- Selektionsbias: Wie man die Stichprobe erhebt, verzerrt sie. Eine Online-Umfrage erreicht nur Personen, die sie gesehen haben und sich entschieden haben, darauf zu antworten.
- Überlebensbias: Man misst nur die Überlebenden. Im Zweiten Weltkrieg untersuchten Ingenieure die zurückkehrenden Flugzeuge, um zu entscheiden, wo Panzerung hinzugefügt werden sollte, und markierten die Einschlaglöcher. Abraham Wald wies darauf hin, dass die Panzerung dort hingehört, wo die zurückkehrenden Flugzeuge KEINE Löcher hatten, denn Flugzeuge, die dort getroffen wurden, kamen nie zurück, um gezählt zu werden.
Die fehlenden Daten, die Personen oder Fälle, die ausgestiegen sind, sind oft wichtiger als die Daten, die man in der Hand hat.
Ein Diagramm ist ein Argument aus Tinte
Vier Wege, wie eine ehrliche Zahl ein unehrliches Diagramm wird
Korrekte Daten können so gezeichnet werden, dass sie irreführend wirken. Lernen Sie die vier häufigsten visuellen Tricks.
- Abgeschnittene Achse: Eine vertikale Achse, die nicht bei null, sondern über null beginnt. Eine Änderung von 50 auf 52 füllt das gesamte Diagramm aus und wirkt enorm, obwohl es sich um eine Veränderung von nur 4 % handelt.
- Doppelte Achsen: Zwei Linien auf zwei verschiedenen vertikalen Skalen, die so angepasst werden, dass sie einander zu folgen scheinen. Die Korrelation wird durch die Wahl der Skalen hergestellt und ist nicht in den Daten vorhanden.
- Ausgewählter Zeitraum: Die Auswahl nur des Zeitfensters, das die Behauptung stützt. Beginnt man ein Diagramm für Temperaturen oder Preise an einem günstigen Höchst- oder Tiefstwert, dreht sich der Trend um.
- Flächen- vs. Längendistortion: Wird die Breite UND die Höhe eines Icons skaliert, um einen verdoppelten Wert darzustellen, wird seine FLÄCHE viermal so groß. Das Auge liest die Fläche, sodass eine 2-fache Darstellung wie eine 4-fache wirkt.
Jeder dieser Tricks verwendet korrekte Zahlen. Die Täuschung liegt in der Darstellung, nicht in den Daten.
Die dritte Variable
Zwei Dinge bewegen sich zusammen. Und?
Wenn zwei Messwerte zusammen steigen und fallen, sind sie korreliert. Korrelation ist real und nützlich, aber sie beweist nicht, dass das eine das andere VERURSACHT. Drei unschuldige Erklärungen konkurrieren immer mit der Kausalität:
- Umgekehrte Kausalität: B könnte A verursachen, nicht umgekehrt.
- Zufall: Bei genügend vielen Variablen werden einige rein zufällig zusammenhängen.
- Ein Störfaktor: Eine verborgene dritte Variable treibt beide an.
Klassisches Beispiel: Der Eisverkauf korreliert mit Ertrinkungstoden. Eis ertrinkt niemanden. Der Störfaktor ist die Sommerhitze, die sowohl den Eisverkauf als auch die Anzahl der Badenden erhöht.
Bevor man eine kausale Behauptung für wahr hält, sollte man nach dem Störfaktor suchen. Frage dich, was für eine dritte Sache beide Zahlen gleichzeitig bewegen könnte.
Die Checkliste des Skeptikers
Ein letzter Gedanke
Du hast nun eine Checkliste für jede Statistik, die dir über den Weg läuft:
1. Maß: Welcher Durchschnitt ist das, und verfälschen Schiefe oder Ausreißer ihn?
2. Streuung: Verdeckt der Durchschnitt starke Schwankungen?
3. Stichprobe: Wer wurde gezählt, wie viele, und wer fehlt?
4. Diagramm: Wo beginnt die Achse, und wurde der Wertebereich willkürlich ausgewählt?
5. Behauptung: Wird diese Korrelation als Kausalität verkauft, und welcher Störfaktor könnte sie erklären?
Genauere Zahlen können trotzdem irreführend sein. Die Zahl ist nie das ganze Argument. Die Entscheidungen dahinter sind es.