Números que mienten mientras dicen la verdad
Lectura de evidencia y estadísticas
Una estadística puede ser completamente precisa y aun así engañarte. Cada número en un titular, un estudio, un panel de control o un informe automatizado sobrevivió a una serie de decisiones antes de llegar a ti. Alguien eligió una medida, una muestra, un rango y un eje.
La habilidad que desarrollas hoy lee las cuatro: la medida (qué promedio), la dispersión (cuánto varían los datos), la muestra (quién fue contado) y el eje (cómo lo dibuja el gráfico).
Cuando esas decisiones no se cuestionan, los números correctos cuentan una historia falsa. Cuando las cuestionas, ves lo que los datos dicen realmente.
Un número en el que creías a medias
Antes de comenzar, piensa en una estadística con la que te hayas encontrado.
Tres promedios, tres historias
La palabra "promedio" oculta una elección
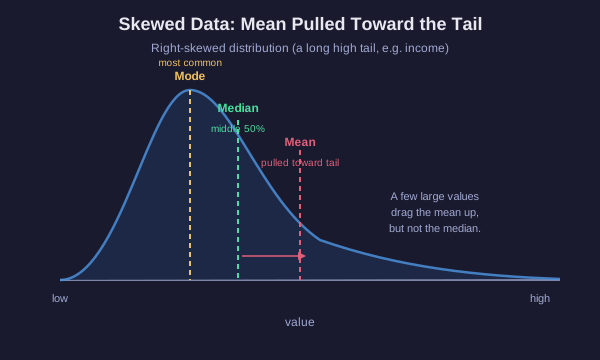
Tres medidas diferentes se llaman todas "promedio". Por lo general, no coinciden, y la brecha entre ellas es información.
- Media: suma todos los valores y divide por la cantidad. Es sensible a cada número, por lo que un solo valor extremo la arrastra.
- Mediana: ordena los valores y toma el del medio. La mitad de los datos está por encima y la mitad por debajo. Un valor atípico apenas la mueve.
- Moda: el valor que aparece con más frecuencia. Útil para categorías y para encontrar el caso típico en una distribución irregular.
Cuando cada una engaña
Consideremos siete hogares con ingresos, en miles: 30, 32, 35, 38, 40, 42 y uno de 250.
La media es de aproximadamente 67k, pero seis de los siete hogares ganan menos que eso. El único valor de 250k elevó la media por encima de casi todos. La mediana es 38k, el punto medio real, y describe mucho mejor a un hogar típico.
Este es el clásico problema de los ingresos. Si se reporta la media, un grupo sesgado parece más rico de lo que es. Si se reporta la mediana, se ve el punto medio.
La regla: en datos sesgados o con valores atípicos, la mediana cuenta la historia honesta. En datos aproximadamente simétricos sin extremos, la media y la mediana casi coinciden y cualquiera de las dos sirve.
Elige la medida honesta
Tu turno
Una ciudad informa que el precio "promedio" de las viviendas es de 900k. Descubres que la mayoría de las viviendas se vendieron entre 250k y 400k, pero tres mansiones se vendieron por más de 6 millones cada una.
Calcúlalo tú mismo
Un pequeño conjunto de datos
Siete empleados de una startup ganan estos salarios anuales, en miles:
40, 42, 45, 48, 50, 55 y el fundador en 400.
Calcula ambas medidas de centro y luego decide cuál de ellas debería confiar un buscador de empleo al imaginar un salario típico aquí.
Mismo promedio, mundos diferentes
Un promedio oculta la dispersión
Dos conjuntos de datos pueden compartir un promedio idéntico y describir realidades completamente diferentes. El promedio no dice nada sobre qué tan lejos se dispersan los valores.
Calificaciones del examen de la Clase A: 78, 80, 82, 80, 80. Promedio 80, todos agrupados estrechamente.
Calificaciones del examen de la Clase B: 40, 100, 60, 100, 100. Promedio 80, pero las calificaciones oscilan salvajemente de reprobatorias a perfectas.
Mismo promedio de 80. Una clase es uniforme, la otra está dividida en estudiantes con dificultades y estrellas. Un informe que dice que ambas clases "promediaron 80" borra esa diferencia.
La dispersión, medida por el rango o la desviación estándar, te indica cuánto varían los valores alrededor del centro. Los promedios sin dispersión son media frase. Pregunta siempre qué tan amplia es la dispersión de los datos.
La muestra es el argumento
Las muestras pequeñas son ruidosas; las muestras sesgadas son incorrectas
Una estadística describe a quien fue medido. Si la muestra es pequeña o no representativa, el número dice poco sobre el mundo más amplio, por muy preciso que parezca.
- Tamaño de la muestra: las muestras pequeñas fluctúan salvajemente por azar. Si lanzas una moneda justa 4 veces, obtener el 100% de caras es común; si la lanzas 4.000 veces, se estabiliza cerca del 50%. Una "mejora del 40%" basada en 10 personas es mayormente ruido.
- Representatividad: una encuesta de un solo barrio, un solo grupo de edad o los usuarios de un solo sitio web no puede hablar por todos. La muestra debe reflejar la población que deseas describir.
- Sesgo de selección: cómo recopilas la muestra la inclina. Una encuesta en línea solo alcanza a las personas que la vieron y eligieron responder.
- Sesgo de supervivencia: solo mides a los supervivientes. En la Segunda Guerra Mundial, los ingenieros estudiaban los aviones que regresaban para decidir dónde añadir blindaje y marcaban los agujeros de bala. Abraham Wald señaló que el blindaje debía ir donde los aviones que regresaban NO tenían agujeros, porque los aviones que fueron alcanzados allí nunca regresaron para ser contados.
Los datos faltantes, las personas o casos que se desprendieron, a menudo importan más que los datos que tienes en mano.
Un gráfico es un argumento con tinta
Cuatro formas en que un número honesto obtiene un gráfico deshonesto
Los datos correctos pueden representarse para engañar. Aprende los cuatro trucos visuales más comunes.
- Eje truncado: un eje vertical que comienza por encima de cero en lugar de en cero. Un cambio de 50 a 52 llena todo el gráfico y parece enorme, aunque es un movimiento del 4 %.
- Ejes dobles: dos líneas en dos escalas verticales diferentes, ajustadas hasta que parecen seguirse entre sí. La correlación está fabricada por la elección de las escalas, no se encuentra en los datos.
- Rango seleccionado a conveniencia: elegir solo la ventana de tiempo que respalda la afirmación. Si se inicia un gráfico de temperatura o precio en un pico o valle conveniente, la tendencia se invierte.
- Distorsión de área frente a longitud: escalar el ancho Y la altura de un icono para mostrar un valor duplicado hace que su ÁREA sea cuatro veces mayor. El ojo lee el área, por lo que una figura de 2x parece de 4x.
Cada uno de estos utiliza números precisos. El engaño reside en el dibujo, no en los datos.
La tercera variable
Dos cosas se mueven juntas. ¿Y qué?
Cuando dos mediciones suben y bajan juntas, están correlacionadas. La correlación es real y útil, pero no demuestra que una CAUSE la otra. Siempre compiten con la causalidad tres explicaciones inocentes:
- Causalidad inversa: B podría causar A, en lugar de que A cause B.
- Coincidencia: con suficientes variables, algunas se correlacionarán por puro azar.
- Un factor de confusión: una tercera variable oculta impulsa ambas.
Ejemplo clásico: las ventas de helado se correlacionan con las muertes por ahogamiento. El helado no ahoga a nadie. El factor de confusión es el calor del verano, que aumenta tanto las ventas de helado como el número de personas que nadan.
Antes de creer una afirmación causal, busca el factor de confusión. Pregúntate qué tercera cosa podría estar moviendo ambos números al mismo tiempo.
La lista de verificación del escéptico
Un último pensamiento
Ahora tienes una lista de verificación para cualquier estadística que se cruce en tu camino:
1. Medición: ¿qué tipo de media es esta y la distorsiona la asimetría o un valor atípico?
2. Dispersión: ¿la media oculta una variación extrema?
3. Muestra: ¿a quién se contó, cuántos son y quién falta?
4. Gráfico: ¿dónde empieza el eje y se ha seleccionado el rango a conveniencia?
5. Afirmación: ¿se está vendiendo esta correlación como causalidad y qué variable confusora podría explicarla?
Los números precisos aún pueden engañar. El número nunca es el argumento completo. Lo son las decisiones detrás de él.