Des chiffres qui mentent en disant la vérité
Lire les preuves et les statistiques
Une statistique peut être parfaitement exacte et vous tromper tout de même. Chaque chiffre dans un titre, une étude, un tableau de bord ou un rapport automatisé a survécu à un ensemble de choix avant de vous parvenir. Quelqu'un a choisi une mesure, un échantillon, une plage et un axe.
La compétence que vous développez aujourd'hui consiste à lire ces quatre éléments : la mesure (quelle moyenne), l'écart (dans quelle mesure les données varient), l'échantillon (qui a été compté) et l'axe (comment le graphique le représente).
Lorsque ces choix ne sont pas remis en question, des chiffres correctes racontent une fausse histoire. Lorsque vous les mettez en question, vous voyez ce que les données disent réellement.
Un chiffre que vous croyiez à moitié
Avant de commencer, pensez à une statistique que vous avez rencontrée.
Trois moyennes, trois histoires
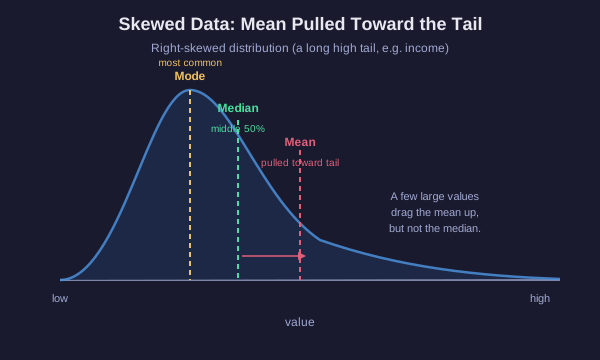
Le mot « moyenne » masque un choix
Trois mesures différentes sont toutes appelées la moyenne. Elles sont généralement en désaccord, et l'écart entre elles est une information.
- Moyenne : on additionne toutes les valeurs, puis on divise par le nombre de valeurs. Sensible à chaque nombre, une seule valeur extrême peut la tirer.
- Médiane : on trie les valeurs, on prend celle du milieu. La moitié des données est au-dessus, l'autre moitié en dessous. Un point aberrant la déplace à peine.
- Mode : la valeur qui apparaît le plus souvent. Utile pour les catégories et pour trouver le cas typique dans une distribution irrégulière.
Quand chacune est trompeuse
Considérez sept foyers dont les revenus, en milliers, sont : 30, 32, 35, 38, 40, 42 et un à 250.
La moyenne est d'environ 67 k, mais six des sept foyers gagnent moins que cela. La seule valeur de 250 k a tiré la moyenne au-dessus de presque tout le monde. La médiane est de 38 k, le véritable milieu, et elle décrit un foyer typique beaucoup mieux.
C'est le piège classique des revenus. Si l'on rapporte la moyenne, un groupe asymétrique semble plus riche qu'il ne l'est réellement. Si l'on rapporte la médiane, on voit le milieu.
La règle : sur des données asymétriques ou contenant des valeurs extrêmes, la médiane raconte l'histoire honnête. Sur des données approximativement symétriques sans extrêmes, la moyenne et la médiane sont presque identiques et l'une ou l'autre convient.
Choisir la mesure honnête
À vous de jouer
Une ville rapporte que le prix « moyen » de ses maisons est de 900 k. Vous apprenez que la plupart des maisons se sont vendues entre 250 k et 400 k, mais que trois manoirs se sont vendus à plus de 6 millions chacun.
Calculez-le vous-même
Un petit jeu de données
Sept employés d'une startup gagnent ces salaires annuels, en milliers :
40, 42, 45, 48, 50, 55 et le fondateur à 400.
Calculez les deux mesures de tendance centrale, puis déterminez laquelle un candidat à un emploi devrait privilégier pour se faire une idée réaliste d'un salaire typique ici.
Même moyenne, mondes différents
Une moyenne masque l'écart
Deux ensembles de données peuvent partager une moyenne identique et décrire des réalités complètement différentes. La moyenne ne dit rien sur l'écart des valeurs.
Notes de l'examen de la classe A : 78, 80, 82, 80, 80. Moyenne de 80, tout le monde est regroupé étroitement.
Notes de l'examen de la classe B : 40, 100, 60, 100, 100. Moyenne de 80, mais les notes varient énormément, de l'échec au sans-faute.
Même moyenne de 80. Une classe est uniforme, l'autre est divisée entre les élèves en difficulté et les brillants. Un rapport indiquant que les deux classes ont « obtenu une moyenne de 80 » efface cette différence.
L'écart, mesuré par l'étendue ou l'écart-type, vous indique dans quelle mesure les valeurs varient autour du centre. Des moyennes sans écart sont une phrase incomplète. Demandez toujours à quelle mesure les données s'écartent.
L'échantillon est l'argument
Les petits échantillons sont bruités ; les échantillons biaisés sont erronés
Une statistique décrit ceux qui ont été mesurés. Si l'échantillon est petit ou non représentatif, le nombre ne dit presque rien sur le monde plus large, quelle que soit la précision apparente.
- Taille de l'échantillon : les petits échantillons varient considérablement par hasard. Lancer une pièce juste 4 fois et obtenir 100 % de faces est courant ; la lancer 4 000 fois et le résultat se stabilise autour de 50 %. Une « amélioration de 40 % » basée sur 10 personnes est principalement du bruit.
- Représentativité : un sondage d'un seul quartier, d'un seul groupe d'âge ou des utilisateurs d'un seul site web ne peut pas parler au nom de tout le monde. L'échantillon doit refléter la population que l'on souhaite décrire.
- Biais de sélection : la manière dont on recueille l'échantillon le déforme. Un sondage en ligne n'atteint que les personnes qui l'ont vu et qui ont choisi d'y répondre.
- Biais de survie : on ne mesure que les survivants. Lors de la Seconde Guerre mondiale, les ingénieurs ont étudié les avions qui revenaient pour décider où ajouter de la blindage et ont marqué les impacts de balles. Abraham Wald a fait remarquer que le blindage devait être placé là où les avions qui revenaient n'avaient PAS de trous, car les avions touchés à ces endroits ne sont jamais revenus pour être comptés.
Les données manquantes, les personnes ou les cas qui ont abandonné, comptent souvent plus que les données que l'on possède.
Un graphique est un argument encre
Quatre façons dont un nombre honnête devient un graphique trompeur
Des données correctes peuvent être dessinées pour induire en erreur. Apprenez les quatre astuces visuelles les plus courantes.
- Axe tronqué : un axe vertical qui commence au-dessus de zéro au lieu de partir de zéro. Un passage de 50 à 52 remplit tout le graphique et semble énorme, alors qu'il ne s'agit que d'une variation de 4 %.
- Double axe : deux lignes sur deux échelles verticales différentes, ajustées jusqu'à ce qu'elles semblent suivre la même trajectoire. La corrélation est fabriquée par le choix des échelles, et non trouvée dans les données.
- Fenêtre temporelle sélective : choisir uniquement la période qui soutient l'affirmation. Faire commencer un graphique de température ou de prix à un pic ou un creux opportun fait basculer la tendance.
- Distorsion surface-longueur : mettre à l'échelle la largeur ET la hauteur d'une icône pour montrer une valeur doublée rend sa SURFACE quatre fois plus grande. L'œil perçoit la surface, donc une figure 2x semble être 4x.
Chacune de ces astuces utilise des chiffres exacts. La tromperie réside dans le dessin, pas dans les données.
La troisième variable
Deux choses évoluent ensemble. Et alors ?
Lorsque deux mesures augmentent et diminuent ensemble, elles sont corrélées. La corrélation est réelle et utile, mais elle ne prouve pas que l'une CAUSE l'autre. Trois explications innocentes sont toujours en concurrence avec la causalité :
- Causalité inverse : B pourrait causer A, et non l'inverse.
- Coïncidence : avec suffisamment de variables, certaines suivront une tendance par simple hasard.
- Un facteur de confusion : une troisième variable cachée est à l'origine des deux.
Exemple classique : les ventes de glaces sont corrélées au nombre de noyades. La glace ne noie personne. Le facteur de confusion est la chaleur estivale, qui augmente à la fois les ventes de glaces et le nombre de personnes qui nagent.
Avant de croire à une affirmation causale, cherchez le facteur de confusion. Demandez-vous quelle troisième chose pourrait faire varier les deux chiffres simultanément.
La liste de vérification du sceptique
Une dernière réflexion
Vous avez désormais une liste de vérification pour toute statistique qui croise votre chemin :
1. Mesure : de quelle moyenne s'agit-il, et la distribution asymétrique ou une valeur aberrante la rendent-elles trompeuse ?
2. Dispersion : la moyenne masque-t-elle une variation importante ?
3. Échantillon : qui a été compté, combien de personnes, et qui est manquant ?
4. Graphique : où commence l'axe, et l'échelle a-t-elle été choisie de manière sélective ?
5. Affirmation : cette corrélation est-elle présentée comme une causalité, et quel facteur de confusion pourrait l'expliquer ?
Des chiffres précis peuvent tout de même induire en erreur. Le nombre n'est jamais l'argument complet. Ce sont les choix qui le sous-tendent.