सच बोलते हुए झूठ बोलने वाली संख्याएँ
साक्ष्य और सांख्यिकी का पठन
एक सांख्यिकी पूर्ण रूप से सटीक हो सकती है और फिर भी आपको धोखा दे सकती है। शीर्षक, अध्ययन, डैशबोर्ड या स्वचालित रिपोर्ट में प्रत्येक संख्या आपके तक पहुँचने से पहले एक श्रृंखला के निर्णयों से गुज़री है। किसी ने एक माप, एक नमूना, एक सीमा और एक अक्ष चुना।
आज आप जो कौशल विकसित करेंगे, वह इन चारों को पढ़ता है: माप (कौन सा औसत), फैलाव (डेटा कितना भिन्न है), नमूना (किसका हिसाब रखा गया), और अक्ष (चार्ट इसे कैसे चित्रित करता है)।
जब ये चयन प्रश्न-मुक्त रहते हैं, तो सही संख्याएँ एक झूठी कहानी कहती हैं। जब आप उन पर प्रश्न उठाते हैं, तो आप देखते हैं कि डेटा वास्तव में क्या कह रहा है।
एक ऐसा आंकड़ा जिस पर आपका आधा विश्वास था
शुरू करने से पहले, किसी ऐसे आंकड़े (statistic) के बारे में सोचें जिससे आपने पहले भी मिलवत किया हो।
तीन औसत, तीन कहानियाँ
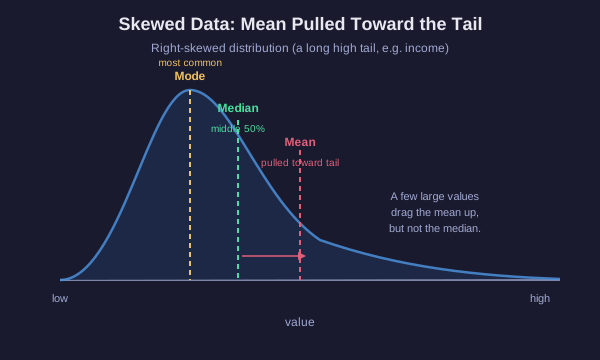
"औसत" शब्द एक चुनाव को छुपाता है
तीन अलग-अलग मापनों को औसत कहा जाता है। वे आमतौर पर असहमत होते हैं, और उनके बीच का अंतर जानकारी है।
- माध्य (Mean): हर मान जोड़ें, फिर गिनती से भाग दें। यह हर संख्या से संवेदनशील है, इसलिए एक अत्यधिक मान इसे खींच लेता है।
- मध्यिका (Median): मानों को क्रमबद्ध करें, बीच वाला लें। आधा डेटा ऊपर है, आधा नीचे। एक आउटलायर इसे बस थोड़ा ही हिलाता है।
- मोड (Mode): वह मान जो सबसे अधिक बार आता है। श्रेणियों के लिए और एक असमान वितरण में सामान्य मामला खोजने के लिए उपयोगी।
जब प्रत्येक एक भ्रामक हो
सात परिवारों पर विचार करें, जिनके आय, हज़ारों में: 30, 32, 35, 38, 40, 42, और एक 250 पर।
माध्य लगभग 67k है, लेकिन सात में से छह परिवार उससे कम कमाते हैं। एकल 250k का मान माध्य को लगभग सभी के ऊपर खींच लाया। मध्यिका 38k है, जो सच में बीच का है, और यह एक सामान्य परिवार का वर्णन बहुत बेहतर करता है।
यह क्लासिक आय ट्रैप है। माध्य की रिपोर्ट करें और एक विकृत समूह उससे भी अमीर दिखता है। मध्यिका की रिपोर्ट करें और आपको बीच दिखता है।
नियम: विकृत डेटा या आउटलायर्स वाले डेटा पर, मध्यिका सच कहती है। लगभग सममित डेटा पर, जिसमें कोई चरम मान नहीं है, माध्य और मध्यिका लगभग सहमत होती हैं और दोनों काम आती हैं।
सच्चे माप का चयन करें
आपकी बारी
एक शहर की रिपोर्ट है कि इसकी "औसत" घर की कीमत 900k है। आपको पता चलता है कि अधिकांश घर 250k और 400k के बीच बिके, लेकिन तीन महल प्रत्येक 6 मिलियन से अधिक में बिके।
खुद गणना करें
एक छोटा डेटासेट
एक स्टार्टअप के सात कर्मचारियों की ये वार्षिक वेतन हैं, हज़ारों में:
40, 42, 45, 48, 50, 55 और संस्थापक का 400।
दोनों केंद्रीय मापों (measures of center) की गणना करें, फिर तय करें कि एक नौकरी खोजने वाला व्यक्ति यहाँ एक सामान्य वेतन की कल्पना करते समय किस माप पर भरोसा करेगा।
एक ही औसत, अलग-अलग दुनियाएँ
औसत स्प्रेड को छुपा देती है
दो डेटासेट एक ही समान माध्य (mean) साझा कर सकते हैं और पूरी तरह अलग वास्तविकताओं का वर्णन कर सकते हैं। औसत यह बताने के लिए कुछ नहीं कहती कि मान कितनी दूर तक फैले हैं।
कक्षा A के परीक्षा अंक: 78, 80, 82, 80, 80। माध्य 80, सभी अंक कसकर एक साथ हैं।
कक्षा B के परीक्षा अंक: 40, 100, 60, 100, 100। माध्य 80, लेकिन अंक विफलता से पूर्णता तक ज़ोरदार उतार-चढ़ाव दिखाते हैं।
माध्य 80 एक ही है। एक कक्षा एकसमान है, जबकि दूसरी कक्षा संघर्षशील छात्रों और सितारों में बंटी हुई है। एक रिपोर्ट जो कहती है कि दोनों कक्षाओं का औसत "80" रहा, वह इस अंतर को मिटा देती है।
स्प्रेड, जो रेंज या मानक विचलन (standard deviation) द्वारा मापा जाता है, आपको बताता है कि मान केंद्र के चारों ओर कितने भिन्न हैं। बिना स्प्रेड के औसत अधूरे वाक्य हैं। हमेशा यह पूछें कि डेटा कितनी चौड़ाई में फैला है।
नमूना ही तर्क है
छोटे नमूने शोर भरे होते हैं; पूर्वाग्रहित नमूने गलत होते हैं
एक सांख्यिकीय माप (statistic) उस व्यक्ति या समूह का वर्णन करता है जिसका मापन किया गया। यदि नमूना छोटा है या प्रतिनिधि (representative) नहीं है, तो वह संख्या बड़े विश्व के बारे में बहुत कम बताती है, चाहे वह कितनी भी सटीक प्रतीत हो।
- नमूना आकार (Sample size): छोटे नमूने संयोग से अत्यधिक उतार-चढ़ाव दिखाते हैं। एक निष्पक्ष सिक्का 4 बार उछालने पर 100% सिर (heads) आना आम बात है; लेकिन 4,000 बार उछालने पर यह लगभग 50% के पास स्थिर हो जाता है। 10 लोगों से प्राप्त "40% सुधार" मुख्य रूप से शोर (noise) है।
- प्रतिनिधित्व (Representativeness): एक पड़ोस, एक आयु वर्ग, या किसी एक वेबसाइट के उपयोगकर्ताओं के एक सर्वेक्षण का कोई भी निष्कर्ष सभी के लिए लागू नहीं हो सकता। नमूना उस जनसंख्या (population) का प्रतिबिंब होना चाहिए जिसका वर्णन आप करना चाहते हैं।
- चयन पूर्वाग्रह (Selection bias): आप नमूना कैसे एकत्रित करते हैं, यह इसे झुका देता है। एक ऑनलाइन सर्वेक्षण केवल उन लोगों तक पहुँचता है जिन्होंने उसे देखा और जवाब देने का निर्णय लिया।
- अवशेषिता पूर्वाग्रह (Survivorship bias): आप केवल उनका मापन करते हैं जिन्होंने बचाव किया। द्वितीय विश्व युद्ध में, इंजीनियरों ने लौटने वाले विमानों का अध्ययन किया यह तय करने के लिए कि कवच (armor) कहाँ जोड़ा जाए, और उन्होंने गोली के छेदों को चिह्नित किया। अब्राहम वाल्ड (Abraham Wald) ने संकेत दिया कि कवच वहाँ होना चाहिए जहाँ लौटने वाले विमानों पर कोई छेद नहीं था, क्योंकि वहाँ लगे विमान वापस लौटकर गिने जाने के लिए कभी नहीं आए।
गुम हुए डेटा, वे लोग या मामले जो बाहर हो गए, अक्सर आपके पास मौजूद डेटा से अधिक महत्वपूर्ण होते हैं।
चार्ट स्याही से लिखा हुआ तर्क है
एक ईमानदार संख्या को गैर-ईमानदार चार्ट बनाने के चार तरीके
सही डेटा को भ्रामक बनाने के लिए बनाया जा सकता है। चार सबसे आम दृश्य चालों (visual tricks) को जानें।
- ट्रंकेटेड एक्सिस (Truncated axis): एक ऊर्ध्वाधर अक्ष जो शून्य पर शुरू होने के बजाय शून्य से ऊपर से शुरू होता है। 50 से 52 तक की वृद्धि पूरा चार्ट भर देती है और बहुत बड़ी लगती है, हालाँकि यह केवल 4% की वृद्धि है।
- डुअल एक्सिस (Dual axes): दो अलग-अलग ऊर्ध्वाधर पैमानों पर दो रेखाएँ, जिन्हें इतना समायोजित किया जाता है कि वे एक-दूसरे के साथ चलती हुई प्रतीत हों। यह सहसंबंध (correlation) पैमानों के चयन से निर्मित होता है, डेटा में नहीं मिलता।
- चेरी-पिक किया गया दायरा (Cherry-picked range): केवल उस समय के विंडो का चयन करना जो दावे को समर्थन करता है। तापमान या मूल्य के चार्ट को एक सुविधाजनक शिखर या न्यूनतम बिंदु से शुरू करें और रुझान उलट जाता है।
- क्षेत्र-विरुद्ध-लंबाई विकृति (Area-vs-length distortion): एक आइकॉन की चौड़ाई और ऊँचाई दोनों को दोगुनी मान प्रदर्शित करने के लिए स्केल करने से इसका क्षेत्रफल चार गुना बड़ा हो जाता है। आँख क्षेत्रफल को पढ़ती है, इसलिए 2x आकृति 4x जैसी लगती है।
इनमें से प्रत्येक सटीक संख्याओं का उपयोग करता है। धोखा डेटा में नहीं, बल्कि चित्रण में निहित होता है।
तीसरी चर
दो चीज़ें साथ में बदलती हैं। तो फिर?
जब दो माप एक साथ बढ़ते और घटते हैं, तो वे सहसंबंधित (correlated) होते हैं। सहसंबंध वास्तविक और उपयोगी है, लेकिन यह साबित नहीं करता कि एक का दूसरे पर कारण (CAUSE) है। कारणता के साथ-साथ हमेशा तीन निर्दोष व्याख्याएं प्रतिस्पर्धा करती हैं:
- उल्टी कारणता (Reverse causation): हो सकता है कि B ही A का कारण हो, न कि A का B पर प्रभाव हो।
- सामंजस्य (Coincidence): पर्याप्त चरों (variables) के साथ, कुछ केवल शुद्ध संयोग से एक-दूसरे के अनुरूप हो सकते हैं।
- एक संकराव (A confounder): एक छिपा हुआ तीसरा चर दोनों को प्रेरित करता है।
क्लासिक उदाहरण: आइस्क्रिम की बिक्री और डूबने से होने वाली मौतों के बीच सहसंबंध होता है। आइस्क्रिम किसी को डुबोता नहीं है। संकराव गर्मी है, जो आइस्क्रिम की बिक्री और तैरने वाले लोगों की संख्या दोनों को बढ़ाती है।
किसी कारणात्मक दावे पर विश्वास करने से पहले, संकराव (confounder) की खोज करें। पूछें कि कौन सा तीसरा कारक एक साथ दोनों संख्याओं को प्रभावित कर सकता है।
संदिग्ध व्यक्ति की चेकलिस्ट
एक अंतिम विचार
अब आपके पास किसी भी सांख्यिकी के लिए एक चेकलिस्ट है जो आपके रास्ते में आती है:
1. माप: यह औसत किस प्रकार का है, और क्या वक्रता (skew) या कोई आउटलायर इसे गलत प्रस्तुत कर रहा है?
2. विस्तार: क्या औसत अत्यधिक विचरण को छुपा रहा है?
3. नमूना: किसे गिना गया, कितने लोगों को, और कौन छूट गया?
4. चार्ट: अक्ष (axis) कहाँ से शुरू होता है, और क्या सीमा (range) का चयन चुनिंदा (cherry-picked) किया गया है?
5. दावा: क्या यह सहसंबंध (correlation) कारण-प्रभाव (causation) के रूप में पेश किया जा रहा है, और कौन सा संयोजक कारक (confounder) इसकी व्याख्या कर सकता है?
सटीक संख्याएँ भी भ्रामक हो सकती हैं। संख्या कभी भी पूरी तर्क नहीं होती। इसके पीछे के निर्णय ही असली तर्क हैं।