Numeri che mentono dicendo la verità
Leggere Evidenze e Statistiche
Una statistica può essere completamente accurata eppure ingannarti. Ogni numero in un titolo, in uno studio, in un cruscotto o in un report automatico ha attraversato una serie di scelte prima di arrivare a te. Qualcuno ha scelto una misura, un campione, un intervallo e un asse.
La competenza che acquisirai oggi legge tutti e quattro gli elementi: la misura (quale media), la variabilità (quanto variano i dati), il campione (chi è stato conteggiato) e l'asse (come il grafico li rappresenta).
Quando queste scelte restano senza scrutinio, numeri corretti raccontano una storia falsa. Quando li metti in discussione, vedi ciò che i dati dicono realmente.
Un numero in cui credi a metà
Prima di iniziare, pensa a una statistica che hai incontrato.
Tre medie, tre storie
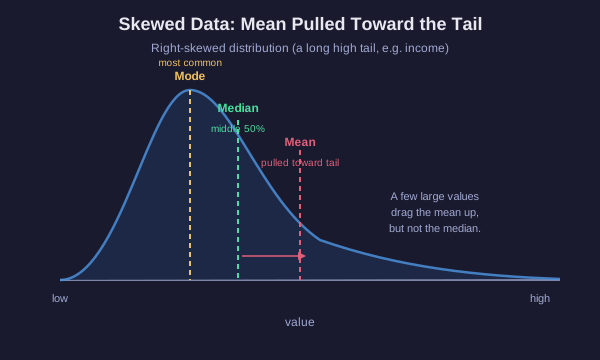
La parola "media" nasconde una scelta
Tre misure diverse vengono tutte chiamate media. Di solito non coincidono, e il divario tra loro è informazione.
- Media aritmetica: si sommano tutti i valori e si divide per il conteggio. È sensibile a ogni numero, quindi un singolo valore estremo la trascina.
- Mediana: si ordinano i valori e si prende quello centrale. Metà dei dati si trova sopra, metà sotto. Un valore anomalo la sposta a malapena.
- Moda: il valore che appare più frequentemente. Utile per le categorie e per trovare il caso tipico in una distribuzione irregolare.
Quando ciascuna misura inganna
Considera sette nuclei familiari con redditi, in migliaia: 30, 32, 35, 38, 40, 42 e uno a 250.
La media è circa 67k, ma sei dei sette nuclei familiari guadagnano meno di quella cifra. Il singolo valore di 250k ha tirato la media sopra quasi tutti. La mediana è 38k, il vero punto centrale, e descrive molto meglio un nucleo familiare tipico.
Questa è la classica trappola dei redditi. Se si riporta la media, un gruppo distorto appare più ricco di quanto non sia. Se si riporta la mediana, si vede il punto centrale.
La regola: su dati distorti o con valori anomali (outlier), la mediana racconta la storia onesta. Su dati approssimativamente simmetrici senza estremi, media e mediana coincidono quasi e va bene usare l'una o l'altra.
Scegli la misura onesta
Il tuo turno
Un comune riporta che il prezzo "medio" delle case è di 900k. Scopri che la maggior parte delle case è stata venduta tra i 250k e i 400k, ma tre ville sono state vendute per oltre 6 milioni ciascuna.
Calcolalo da solo
Un piccolo dataset
Sette dipendenti di una startup guadagnano questi stipendi annuali, in migliaia:
40, 42, 45, 48, 50, 55 e il fondatore a 400.
Calcola entrambe le misure di posizione centrale, poi decidi a quale dovrebbe affidarsi un candidato al lavoro per immaginare uno stipendio tipico in questo contesto.
Stessa media, mondi diversi
Una media nasconde la dispersione
Due set di dati possono condividere una media identica e descrivere realtà completamente diverse. La media non dice nulla su quanto i valori si disperdano.
Voti del test della Classe A: 78, 80, 82, 80, 80. Media 80, tutti i voti sono strettamente raggruppati.
Voti del test della Classe B: 40, 100, 60, 100, 100. Media 80, ma i voti oscillano selvaggiamente da insufficenti a perfetti.
Stessa media di 80. Una classe è uniforme, l'altra è divisa tra chi fatica e chi eccelle. Un rapporto che afferma che entrambe le classi "hanno fatto una media di 80" cancella quella differenza.
La dispersione, misurata tramite l'ampiezza o la deviazione standard, ti dice quanto i valori variano attorno al centro. Le medie senza dispersione sono mezza frase. Chiedi sempre quanto i dati si disperdono.
Il campione è l'argomento
I campioni piccoli sono rumorosi; i campioni distorti sono sbagliati
Una statistica descrive chi è stato misurato. Se il campione è piccolo o non rappresentativo, il numero dice poco sul mondo più ampio, per quanto preciso possa apparire.
- Dimensione del campione: i campioni piccoli oscillano in modo selvaggio per caso. Lancia una moneta equa 4 volte e il 100% di teste è comune; lanciala 4.000 volte e si stabilizza vicino al 50%. Un "miglioramento del 40%" da 10 persone è per lo più rumore.
- Rappresentatività: un sondaggio di un solo quartiere, di un solo gruppo d'età o degli utenti di un solo sito web non può parlare per tutti. Il campione deve riflettere la popolazione che si desidera descrivere.
- Bias di selezione: il modo in cui si raccoglie il campione lo distorce. Un sondaggio online raggiunge solo le persone che lo hanno visto e hanno scelto di rispondere.
- Bias del sopravvissuto: si misurano solo i sopravvissuti. Nella Seconda Guerra Mondiale, gli ingegneri studiarono gli aerei che tornavano per decidere dove aggiungere l'armatura e segnarono i fori delle pallottole. Abraham Wald fece notare che l'armatura andava dove gli aerei che tornavano NON avevano fori, perché gli aerei colpiti lì non tornarono mai a essere conteggiati.
I dati mancanti, le persone o i casi che sono caduti, spesso contano più dei dati che si hanno in mano.
Un grafico è un argomento scritto con l'inchiostro
Quattro modi in cui un numero onesto diventa un grafico disonesto
Dati corretti possono essere rappresentati in modo da indurre in errore. Impara i quattro trucchi visivi più comuni.
- Asse troncato: un asse verticale che inizia sopra lo zero invece che allo zero. Un passaggio da 50 a 52 riempie l'intero grafico e sembra enorme, sebbene si tratti di una variazione del 4%.
- Doppie assi: due linee su due scale verticali diverse, calibrate finché non sembrano seguire l'una l'altra. La correlazione è fabbricata dalla scelta delle scale, non trovata nei dati.
- Intervallo selezionato a piacere: scegliere solo la finestra temporale che supporta l'affermazione. Inizia un grafico delle temperature o dei prezzi da un picco o da un minimo conveniente e la tendenza si inverte.
- Distorsione area-lunghezza: scalare la larghezza E l'altezza di un'icona per mostrare un valore raddoppiato ne rende l'AREA quattro volte più grande. L'occhio legge l'area, quindi una figura 2x sembra 4x.
Ognuno di questi utilizza numeri accurati. L'inganno risiede nel disegno, non nei dati.
La Terza Variabile
Due cose si muovono insieme. E allora?
Quando due misurazioni salgono e scendono insieme, sono correlate. La correlazione è reale e utile, ma non dimostra che una CAUSA l'altra. Tre spiegazioni innocue competono sempre con la causalità:
- Causalità inversa: potrebbe essere B a causare A, non A a causare B.
- Coincidenza: con variabili sufficienti, alcune seguiranno l'andamento di altre per pura fortuna.
- Un confondente: una terza variabile nascosta guida entrambe.
Esempio classico: le vendite di gelato sono correlate ai decessi per annegamento. Il gelato non affoga nessuno. Il confondente è il calore estivo, che aumenta sia le vendite di gelato sia il numero di persone che nuotano.
Prima di credere a un'affermazione causale, cerca il confondente. Chiediti quale terza cosa potrebbe muovere entrambe le cifre contemporaneamente.
La checklist dello scettico
Un'ultima riflessione
Ora hai una checklist per qualsiasi statistica che ti si presenti:
1. Misura: di quale media si tratta e la sua asimmetria o la presenza di valori anomali la rendono fuorviante?
2. Dispersione: la media nasconde una forte variabilità?
3. Campione: chi è stato incluso, in quanti sono e chi è stato escluso?
4. Grafico: da dove parte l'asse e l'intervallo di valori è stato scelto in modo parziale?
5. Affermazione: questa correlazione viene presentata come causalità e quale variabile confondente potrebbe spiegarla?
Numeri accurati possono comunque fuorviare. Il numero non è mai l'intero argomento. Lo sono le scelte che ci sono dietro.