Liczby, które kłamią, mówiąc prawdę
Czytanie dowodów i statystyk
Statystyka może być całkowicie dokładna, a mimo to wprowadzać Cię w błąd. Każda liczba w nagłówku, badaniu, tablicy wskaźników lub automatycznym raporcie przeszła przez serię wyborów, zanim dotarła do Ciebie. Ktoś wybrał miarę, próbkę, zakres i oś.
Umiejętność, którą budujesz dzisiaj, czyta wszystkie cztery elementy: miarę (która średnia), rozrzut (jak bardzo dane się różnią), próbkę (kogo uwzględniono) oraz oś (jak wykres to przedstawia).
Gdy te wybory pozostają bezkrytyczne, poprawne liczby opowiadają fałszywą historię. Gdy je kwestionujesz, widzisz, co dane mówią naprawdę.
Liczba, w którą wierzysz tylko połowicznie
Zanim zaczniemy, pomyśl o statystyce, z którą się spotkałeś.
Trzy średnie, trzy historie
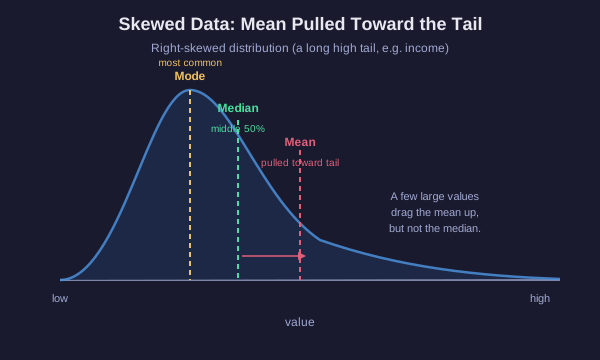
Słowo „średnia” ukrywa wybór
Trzy różne miary są nazywane średnią. Zwykle się różnią, a rozbieżność między nimi jest informacją.
- Średnia arytmetyczna: dodaj wszystkie wartości i podziel przez ich liczbę. Jest wrażliwa na każdą wartość, więc pojedyncza wartość skrajna ją przesuwa.
- Mediana: posortuj wartości i weź tę środkową. Połowa danych leży powyżej, połowa poniżej. Wartość odstająca ledwo ją zmienia.
- Tryb: wartość, która występuje najczęściej. Przydatna dla kategorii oraz do znajdowania typowego przypadku w rozkładzie o nierównej gęstości.
Kiedy każda z nich wprowadza w błąd
Rozważmy siedem gospodarstw domowych o dochodach, w tysiącach: 30, 32, 35, 38, 40, 42 oraz jedno wynoszące 250.
Średnia arytmetyczna wynosi około 67 tys., ale sześć z siedmiu gospodarstw domowych zarabia mniej niż ta kwota. Pojedyncza wartość 250 tys. wyciągnęła średnią powyżej poziomu niemal wszystkich pozostałych. Mediana wynosi 38 tys., jest to prawdziwy środek i znacznie lepiej opisuje typowe gospodarstwo domowe.
To klasyczna pułapka dotycząca dochodów. Zgłaszając średnią, grupa o skośnym rozkładzie wydaje się bogatsza, niż jest w rzeczywistości. Zgłaszając medianę, widzimy środek.
Zasada: w przypadku danych o skośnym rozkładzie lub danych z wartościami odstającymi, to mediana opowiada uczciwą historię. W przypadku danych przybliżenie symetrycznych bez wartości skrajnych, średnia i mediana są niemal zgodne i można użyć dowolnej z nich.
Wybierz uczciwą miarę
Twoja kolej
Miasto raportuje, że jego „średnia” cena domu wynosi 900 tys. Dowiadujesz się, że większość domów sprzedano w przedziale od 250 tys. do 400 tys., ale trzy pałace sprzedano po ponad 6 milionów każdy.
Oblicz to samodzielnie
Mały zbiór danych
Siedmiu pracowników startupu otrzymuje te roczne wynagrodzenia, w tysiącach:
40, 42, 45, 48, 50, 55 oraz założyciel na poziomie 400.
Oblicz oba miary położenia, a następnie zdecyduj, której z nich poszukujący pracy powinien ufać, wyobrażając sobie typową pensję w tym miejscu.
Ta sama średnia, różne światy
Średnia ukrywa rozrzut
Dwa zbiory danych mogą mieć identyczną średnią i opisywać zupełnie różne rzeczywistości. Średnia nie mówi nic o tym, jak bardzo wartości się rozpraszają.
Wyniki testu klasy A: 78, 80, 82, 80, 80. Średnia 80, wszyscy skupieni ciasno wokół niej.
Wyniki testu klasy B: 40, 100, 60, 100, 100. Średnia 80, ale wyniki gwałtownie wahają się od niezdanych do perfekcyjnych.
Ta sama średnia 80. Jedna klasa jest jednorodna, druga podzielona na słabszych i gwiazdy. Raport stwierdzający, że obie klasy „mają średnią 80”, wymazuje tę różnicę.
Rozrzut, mierzony przez zakres lub odchylenie standardowe, mówi, jak bardzo wartości różnią się od wartości centralnej. Średnia bez rozrzutu to pół zdania. Zawsze pytaj, jak szeroko dane się rozpraszają.
Próbka to argument
Małe próbki są szumowe; obciążone próbki są błędne
Statystyka opisuje tych, których zmierzono. Jeśli próbka jest mała lub nieprzestawicielska, liczba mówi niewiele o szerszym świecie, niezależnie od tego, jak precyzyjnie wygląda.
- Rozmiar próbki: małe próbki gwałtownie wahają się z przypadku. Rzucenie sprawiedliwą monetą 4 razy i uzyskanie 100% orłów jest częste; rzucenie jej 4000 razy i wynik stabilizuje się w okolicach 50%. „40% poprawa” z 10 osób to w dużej mierze szum.
- Przestawicielskość: sondaż jednej dzielnicy, jednej grupy wiekowej lub użytkowników jednej witryny nie może mówić za wszystkich. Próbka musi odzwierciedlać populację, którą chcesz opisać.
- Obciążenie selekcyjne: sposób, w jaki zbierasz próbkę, ją zniekształca. Ankieta online dotyka tylko tych, którzy ją zobaczyli i zdecydowali się odpowiedzieć.
- Obciążenie przeżywalności: mierzysz tylko tych, którzy przeżyli. W drugiej wojnie światowej inżynierowie badali wracające samoloty, aby zdecydować, gdzie dodać pancerz, i zaznaczali dziury po kulach. Abraham Wald wskazał, że pancerz powinien być tam, gdzie wracające samoloty NIE miały dziur, ponieważ samoloty trafione w te miejsca nigdy nie wróciły, by zostać policzone.
Brakujące dane, osoby lub przypadki, które wypadły, często mają większe znaczenie niż dane, które posiadasz.
Wykres to argument zapisany tuszem
Cztery sposoby, w jakie uczciwa liczba trafia na nieuczciwy wykres
Poprawne dane mogą zostać przedstawione w sposób wprowadzający w błąd. Poznaj cztery najczęstsze wizualne sztuczki.
- Przycięta oś: oś pionowa, która zaczyna się powyżej zera zamiast od zera. Zmiana z 50 na 52 wypełnia cały wykres i wygląda na ogromną, choć jest to ruch o 4%.
- Podwójne osie: dwie linie na dwóch różnych pionowych skalach, dostrojone tak, aby wydawało się, że podążają za sobą. Korelacja jest wytworem wyboru skal, a nie odnaleziona w danych.
- Wyselekcjonowany zakres: wybór tylko takiego okna czasowego, które wspiera tezę. Rozpoczęcie wykresu temperatury lub ceny od wygodnego szczytu lub dołku odwraca trend.
- Zniekształcenie powierzchni vs. długości: skalowanie szerokości ORAZ wysokości ikony w celu pokazania podwojonej wartości sprawia, że jej POWIERZCHNIA staje się czterokrotnie większa. Oko odczytuje powierzchnię, więc figura 2x wygląda jak 4x.
Każda z tych sztuczek używa dokładnych liczb. Oszustwo tkwi w rysunku, a nie w danych.
Zmienna trzecia
Dwie rzeczy zmieniają się razem. I co z tego?
Gdy dwie wielkości rosną i spadają razem, są skorelowane. Korelacja jest zjawiskiem realnym i przydatnym, ale nie dowodzi, że jedno ZWYKŁE powoduje drugie. Zawsze rywalizują z przyczynowością trzy niewinne wyjaśnienia:
- Odwrócona przyczynowość: to B może powodować A, a nie A powoduje B.
- Zbieg okoliczności: przy wystarczającej liczbie zmiennych niektóre będą się śledzić z czystego przypadku.
- Zmienna zakłócająca: ukryta trzecia zmienna napędza obie pozostałe.
Klasyczny przykład: sprzedaż lodów koreluje z liczbą zgonów przez utonięcie. Lody nie topią nikogo. Zmienną zakłócającą jest letnia upał, która podnosi zarówno sprzedaż lodów, jak i liczbę osób pływających.
Zanim uwierzysz w twierdzenie o przyczynowości, poszukaj zmiennej zakłócającej. Zapytaj, co mogłoby jednocześnie wpływać na obie wielkości.
Checklista sceptyka
Jedna ostatnia myśl
Masz teraz checklistę na każdy statystyk, który spotkasz na swojej drodze:
1. Mierz: jaka to średnia i czy asymetria lub wartość odstająca nie wprowadzają jej w błąd?
2. Rozrzut: czy średnia nie ukrywa dużych wahań?
3. Próbka: kogo uwzględniono, ilu to było i kogo brakuje?
4. Wykres: od czego zaczyna się oś i czy zakres został wybrany pod kątem tezy?
5. Teza: czy korelacja jest tu przedstawiana jako przyczynowość i jaki czynnik zakłócający mógłby to wyjaśnić?
Dokładne liczby mogą nadal wprowadzać w błąd. Liczba nigdy nie jest całym argumentem. To wybory stojące za nią są kluczowe.