真実を語りながら嘘をつく数字
証拠と統計を読む
統計は完全に正確でありながら、あなたを欺く可能性があります。見出し、研究、ダッシュボード、または自動レポートにあるすべての数字は、あなたに届く前に一連の選択を経てきました。誰かが測定値、サンプル、範囲、そして軸を選びました。
今日身につけるスキルは、これら4つすべてを読み解くものです:測定値(どの平均か)、ばらつき(データがどれだけ変動するか)、サンプル(誰がカウントされたか)、そして軸(チャートがそれをどのように描くか)。
これらの選択が疑われることなく受け入れられると、正しい数字が偽りの物語を語ることになります。しかし、それらを疑うことで、データが実際に何を語っているのかを見抜くことができます。
半信半疑だったあの数字
始める前に、あなたがこれまで目にしてきた統計データについて考えてみてください。
3つの平均、3つの物語
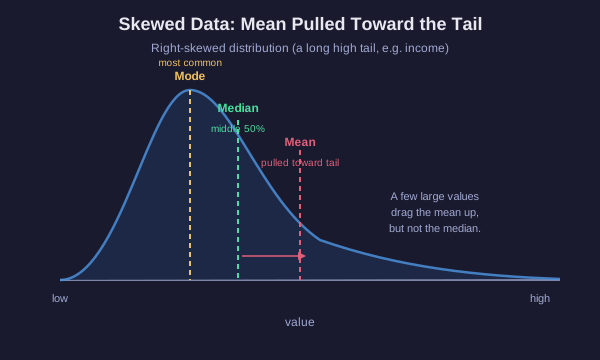
「平均」という言葉が隠している選択
3つの異なる統計量がいずれも「平均」と呼ばれます。これらは通常、値が一致せず、その差には情報が含まれています。
- 平均値(mean): すべての値を足し、個数で割ります。すべての数値に敏感なため、極端な値が1つあるだけで大きく引きずられます。
- 中央値(median): 値を並べ替え、真ん中のものを取ります。データの半分が上、半分が下にあります。外れ値がほとんど影響しません。
- 最頻値(mode): 最も頻繁に現れる値です。カテゴリや、不揃いな分布における典型的なケースを見つけるのに役立ちます。
各指標が誤解を招く場面
年収(単位:1000ドル)が30、32、35、38、40、42、そして250の7世帯を考えます。
平均値は約67kですが、7世帯のうち6世帯の収入はそれ以下です。たった一つの250kという値が、平均値をほぼ全員の上まで引き上げました。中央値は38kで、真ん中の値であり、典型的な世帯をより正確に表しています。
これは典型的な所得の罠です。平均値を報告すると、歪んだ集団が実際より裕福に見えます。中央値を報告すれば、中間の姿が見えます。
ルール:データが歪んでいる場合や外れ値がある場合は、中央値が誠実な物語を語ります。ほぼ対称で極端な値がないデータでは、平均値と中央値はほぼ一致し、どちらを使っても構いません。
誠実な尺度を選ぶ
あなたの番です
ある町は、その町の「平均」住宅価格が900kだと報告しています。しかし、ほとんどの住宅は250kから400kの間に取引されており、3つの豪邸がそれぞれ600万ドル以上で売られたことが判明しました。
自分で計算してみよう
小さなデータセット
スタートアップ企業の7人の従業員が、以下の年間給与(単位:千)をもらっています:
40、42、45、48、50、55、そして創業者の400。
両方の中心値を計算し、求職者がこの場所の典型的な給与をイメージする際にどちらを信頼すべきか判断してください。
同じ平均、異なる世界
平均値は分散を隠す
2つのデータセットは同じ平均値を持ちながら、全く異なる現実を描写している可能性がある。平均値は、値がどれだけ散らばっているかについて何も語らない。
Aクラスのテストスコア:78, 80, 82, 80, 80。平均値は80で、全員が狭い範囲に集まっている。
Bクラスのテストスコア:40, 100, 60, 100, 100。平均値は80だが、不合格から満点までスコアが激しく振れている。
平均値はどちらも80。1つのクラスは均一だが、もう1つのクラスは苦戦している生徒と優秀な生徒に分かれている。「両クラスとも平均80だった」という報告は、その違いを消し去る。
分散(範囲や標準偏差で測定される)は、値が中心値の周りでどれだけ変化するかを教えてくれる。分散のない平均値は、文の半分である。データがどれだけ広がっているかを常に問おう。
サンプルこそが主張である
サンプルが小さいとノイズが大きく、偏りのあるサンプルは誤り
統計量は、測定された対象(サンプル)についてのみ説明します。サンプルが小さかったり非代表性があったりする場合、その数値がどれほど精密に見えようとも、より広い世界(母集団)についてほとんど語ることができません。
- サンプルサイズ: 小さなサンプルは偶然によって大きく変動します。公平なコインを4回投げると100%表になることはよくありますが、4,000回投げると50%付近に収束します。10人からの「40%の改善」は、主にノイズです。
- 代表性: 一つの地域、一つの年齢層、または一つのウェブサイトのユーザーを対象とした世論調査は、全員を代表することはできません。サンプルは、記述したい母集団を反映していなければなりません。
- 選択バイアス: サンプルを収集する方法が、結果に偏りをもたらします。オンライン調査は、それを見た人々で、回答を選択した人々しか到達しません。
- サバイバーバイアス: 生存者(残ったもの)のみを測定することになります。第二次世界大戦中、エンジニアたちは帰還した飛行機を研究し、どこに装甲を追加すべきかを決めるために、銃弾の穴をマークしました。アブラハム・ワルドは、帰還した飛行機に穴がなかった場所に装甲を施すべきだと指摘しました。なぜなら、そこに撃たれた飛行機は帰還して計数されることすらなかったからです。
欠落したデータ、つまり脱落した人々やケースは、あなたが持っているデータよりも重要であることが多いです。
グラフはインクで描かれた主張である
誠実な数値が不誠実なグラフになる4つの方法
正確なデータでも、誤解を招くように描くことは可能です。最も一般的な4つの視覚的なトリックを学びましょう。
- 軸の切り詰め(Truncated axis): 縦軸がゼロではなく、ゼロより上の値から始まること。50から52への変化がチャートの全体を埋め尽くし、非常に大きく見えるようになりますが、実際には4%の変化に過ぎません。
- 二重軸(Dual axes): 異なる2つの縦軸スケール上に2本の線を描き、それらが互いに追従しているように見えるまで調整すること。この相関関係はデータから発見されたものではなく、スケールの選択によって人為的に作られたものです。
- 範囲の選別(Cherry-picked range): 主張を支持する時間窓のみを選択すること。気温や価格のチャートを都合の良いピークやボトムから始めると、トレンドが逆転して見えます。
- 面積と長さの歪み(Area-vs-length distortion): 値が2倍になったことを示すために、アイコンの幅と高さを両方スケールすると、その面積は4倍になります。目は面積を読み取るため、2倍の図形は4倍のように見えます。
これらすべての手法は、正確な数値を使用しています。欺瞞はデータではなく、描き方の中にあります。
第三の変数
二つのものが一緒に動く。それでどうなる?
2つの測定値が一緒に上昇し、一緒に低下する場合、それらは相関していると言えます。相関は実在し有用ですが、片方がもう片方を原因していることを証明するものではありません。因果関係と常に競合する無害な説明が3つあります:
- 逆因果: BがAの原因であり、AがBの原因ではない可能性があります。
- 偶然:変数が十分多ければ、いくつかは純粋な偶然によって連動します。
- 交絡因子:隠れた第3の変数が両方を駆動している可能性があります。
古典的な例:アイスクリームの販売数と溺死による死亡数には相関があります。アイスクリームが誰かを溺死させるわけではありません。交絡因子は夏の暑さであり、これがアイスクリームの販売数と水泳をする人の数を同時に増加させます。
因果関係の主張を信じる前に、交絡因子を探してください。両方の数値を同時に動かす可能性がある第3の要因は何かを問いましょう。
懐疑者のチェックリスト
最後に一つだけ
これにより、目の前に現れるあらゆる統計データに対して使えるチェックリストが手に入りました:
1. 測定: これはどの平均値か、また歪み(偏り)や外れ値によってその値が誤解を招いていないか?
2. 分散: その平均値が激しい変動を隠していないか?
3. サンプル: 誰がカウントされ、何人分であり、誰が欠落しているか?
4. グラフ: 軸はどこから始まっており、範囲は意図的に選定されていないか?
5. 主張: これは相関が因果関係として売り込まれておらず、それを説明しうる交絡因子(confounder)は何か?
正確な数字であっても、誤解を招く可能性がある。数字そのものが議論のすべてではない。その背後にある選択こそが重要なのだ。