在陈述事实的同时撒谎的数字
解读证据与统计数据
统计数据可能完全准确,却依然会欺骗你。标题、研究、仪表盘或自动化报告中的每一个数字,在到达你面前之前,都经历了一系列的选择。有人选择了度量方式、样本、范围以及坐标轴。
你今天将培养的技能能够解读这四个要素:度量方式(哪种平均值)、分布(数据波动有多大)、样本(谁被统计在内)以及坐标轴(图表如何绘制)。
当这些选择未被质疑时,正确的数字会讲述虚假的故事。当你质疑它们时,你才能看到数据实际表达的内容。
一个你似信非信的数字
在开始之前,请回想一下你曾遇到过的某个统计数据。
三种平均值,三种叙事
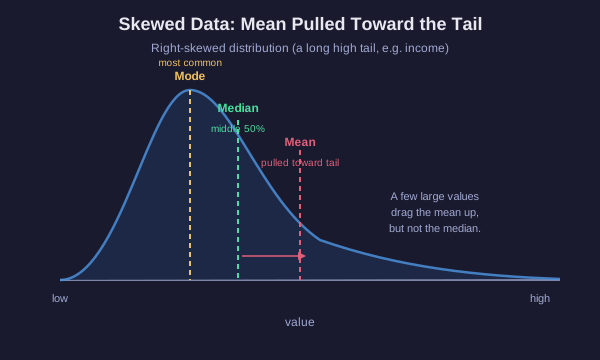
“平均”一词掩盖了一种选择
三种不同的度量都被称为“平均数”。它们通常不一致,而它们之间的差距本身就是一种信息。
- 均值:将所有数值相加,再除以数量。它对每个数值都敏感,因此单个极端值会将其拉偏。
- 中位数:将数值排序,取中间的那个。一半的数据在它之上,一半在它之下。异常值几乎不会移动它。
- 众数:出现频率最高的数值。适用于类别数据,也适用于在分布不均(“块状”)的数据集中寻找典型情况。
何时每种度量会产生误导
考虑七个家庭,其收入(以千为单位)分别为:30、32、35、38、40、42 和 250。
平均值约为 67k,但七个家庭中有六个的收入低于此数值。那个单独的 250k 数值将平均值拉高到了几乎所有人的水平之上。中位数是 38k,即真正的中间值,它能更好地描述典型家庭的情况。
这是经典的收入陷阱。报告平均值会让偏态群体看起来比实际更富裕。报告中位数则能看到中间水平。
规则如下:对于偏态数据或包含异常值的数据,中位数能讲述真实的故事。对于大致对称且无极端值的数据,平均值和中位数几乎一致,两者皆可。
选择诚实的度量
轮到你了
某城镇报告其“平均”房价为 900k。你得知大多数房屋售价在 250k 到 400k 之间,但有三座豪宅每座售价均超过 600 万。
自己动手计算
一个小数据集
一家初创公司的七名员工每年的薪水如下(单位:千):
40、42、45、48、50、55,以及创始人的 400。
计算出这两个中心趋势度量值,然后判断求职者在想象这里的典型薪资时应该相信哪一个。
相同的平均值,不同的世界
平均值掩盖了离散程度
两个数据集可以拥有完全相同的平均值,却描述着截然不同的现实。平均值并未说明数值偏离中心的程度。
A 班测试成绩:78, 80, 82, 80, 80。平均值为 80,所有分数紧密聚集。
B 班测试成绩:40, 100, 60, 100, 100。平均值为 80,但分数在不及格与满分之间剧烈波动。
平均值同为 80。一个班级表现均匀,另一个班级则分化为 struggling 者和明星。一份声称两个班级“平均分为 80”的报告抹杀了这种差异。
离散程度(通过极差或标准差衡量)告诉你数值围绕中心变化的幅度。没有离散程度的平均值只是半句话。务必询问数据分布的宽度。
样本即论据
小样本充满噪声;有偏样本则是错误的
统计量描述的是被测量的对象。如果样本过小或具有代表性不足,无论该数字看起来多么精确,它都无法反映更广泛的世界。
- 样本量:小样本会因随机性而剧烈波动。抛一枚公平硬币4次,出现100%正面的情况很常见;但抛4,000次,结果就会稳定在50%左右。来自10个人的“40%改进”大多是噪声。
- 代表性:针对一个社区、一个年龄段或一个网站用户的调查无法代表所有人。样本必须反映你想要描述的总体。
- 选择偏差:你收集样本的方式会使其产生倾斜。在线调查只能触达那些看到它并选择回答的人。
- 幸存者偏差:你只测量了幸存者。在第二次世界大战中,工程师们研究返航的飞机以决定在哪里增加装甲,并标记了弹孔位置。亚伯拉罕·沃尔德(Abraham Wald)指出,装甲应该加在返航飞机没有弹孔的地方,因为在那里被击中的飞机根本没有返航,因此未被统计在内。
缺失的数据,即那些退出或脱落的人员或案例,往往比你手头拥有的数据更重要。
图表是用墨水书写的论证
诚实的数据如何被不诚实的图表扭曲
准确的数据也可以被绘制成具有误导性的图表。了解四种最常见的视觉技巧。
- 截断坐标轴:垂直轴不从零开始,而是从高于零的数值开始。从 50 到 52 的变化填满了整个图表,看起来非常巨大,尽管这只是一个 4% 的变动。
- 双轴:两条线位于两个不同的垂直比例上,经过调整直到它们看起来彼此追踪。这种相关性是由比例的选择人为制造的,而非数据中固有的。
- 挑选范围:仅选择支持该主张的时间窗口。从方便的峰值或谷值开始绘制温度或价格图表,趋势就会反转。
- 面积与长度失真:通过同时缩放图标的宽度和高度来显示翻倍的值,会使其面积变为原来的四倍。眼睛读取的是面积,因此 2 倍的数字看起来像 4 倍。
这些技巧中的每一个都使用了准确的数字。欺骗存在于绘制方式中,而非数据本身。
第三变量
两件事物一起变化。那又怎样?
当两个测量值同步升降时,它们之间存在相关性。相关性是真实且有用的,但它并不能证明其中一个导致了另一个。与因果关系竞争的三种无害解释始终存在:
- 反向因果:可能是 B 导致了 A,而不是 A 导致了 B。
- 巧合:当变量足够多时,某些变量之间纯粹出于偶然也会出现同步变化。
- 混杂因素:一个隐藏的第三变量同时驱动了两者。
经典例子:冰淇淋销量与溺水死亡人数呈正相关。冰淇淋并不会让人溺水。这里的混杂因素是夏季高温,它同时推高了冰淇淋销量和游泳人数。
在相信某个因果主张之前,要寻找混杂因素。问问自己:有什么第三件事可能同时推动这两个数值的变化?
怀疑论者的检查清单
最后一点思考
现在你拥有一份检查清单,可用于审视任何你遇到的统计数据:
1. 测量:这是哪种平均值?偏态或异常值是否使其失真?
2. 离散度:平均值是否掩盖了剧烈的波动?
3. 样本:统计了谁?有多少人?谁被遗漏了?
4. 图表:坐标轴从哪里开始?范围是否经过刻意挑选?
5. 结论:这种相关性是否被包装成了因果性?可能有什么混杂因素能解释这一现象?
准确的数字依然可能具有误导性。数字本身从来不是完整的论证。其背后的选择才是。