Числа, которые лгут, говоря правду
Чтение доказательств и статистики
Статистика может быть полностью точной и при этом вводить вас в заблуждение. Каждое число в заголовке, исследовании, дашборде или автоматическом отчете прошло через ряд решений, прежде чем дойти до вас. Кто-то выбрал метрику, выборку, диапазон и ось.
Навык, который вы развиваете сегодня, учит читать все четыре аспекта: метрику (какое среднее значение), разброс (насколько варьируются данные), выборку (кто был учтен) и ось (как график это отображает).
Когда эти выборки остаются без критического осмысления, правильные числа рассказывают ложную историю. Когда вы их оспариваете, вы видите, что данные говорят на самом деле.
Число, в которое вы верили лишь наполовину
Прежде чем мы начнем, подумайте о статистике, с которой вы сталкивались.
Три средних значения, три истории
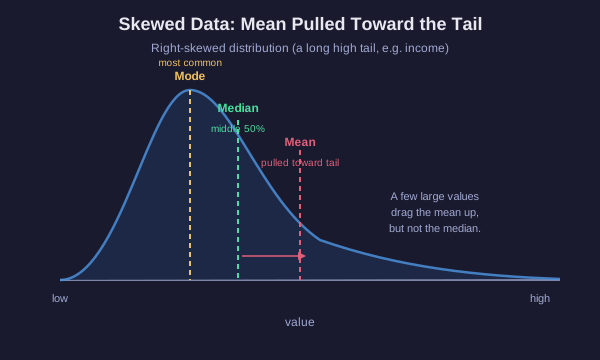
Слово «среднее» скрывает выбор
Три разных меры все называют средним значением. Обычно они расходятся, и разрыв между ними несёт в себе информацию.
- Среднее арифметическое (Mean): сложите все значения и разделите на их количество. Чувствительно к каждому числу, поэтому одно экстремальное значение тянет его за собой.
- Медиана (Median): отсортируйте значения и возьмите среднее. Половина данных находится выше, половина — ниже. Влияние выброса на неё минимально.
- Мода (Mode): значение, которое встречается чаще всего. Полезно для категорий и для поиска типичного случая в неравномерном распределении.
Когда каждая из них вводит в заблуждение
Рассмотрим семь домохозяйств с доходами, выраженными в тысячах: 30, 32, 35, 38, 40, 42 и одно — 250.
Среднее арифметическое составляет около 67 тыс., но шесть из семи домохозяйств зарабатывают меньше этой суммы. Единственное значение в 250 тыс. притянуло среднее выше уровня почти всех остальных. Медиана равна 38 тыс., это истинная середина, и она гораздо лучше описывает типичное домохозяйство.
Это классическая ловушка при анализе доходов. Если сообщать о среднем значении, группа с асимметричным распределением будет выглядеть богаче, чем есть на самом деле. Если сообщать о медиане, вы увидите реальный средний уровень.
Правило: для асимметричных данных или данных с выбросами медиана рассказывает честную историю. Для примерно симметричных данных без крайних значений среднее и медиана почти совпадают, и подходит любой из этих показателей.
Выберите честный показатель
Ваш ход
Город сообщает, что «средняя» цена дома составляет 900 тыс. Вы узнаёте, что большинство домов продавалось за сумму от 250 тыс. до 400 тыс., но три особняка были проданы по цене более 6 миллионов каждый.
Вычислите сами
Небольшой набор данных
Семь сотрудников стартапа получают следующие годовые зарплаты (в тысячах):
40, 42, 45, 48, 50, 55 и основатель на 400.
Вычислите обе меры центра, а затем решите, какой из них соискателю следует доверять, чтобы представить типичную зарплату здесь.
Одинаковое среднее, разные миры
Среднее значение скрывает разброс
Два набора данных могут иметь одинаковое среднее значение и при этом описывать совершенно разные реальности. Среднее ничего не говорит о том, насколько сильно значения рассеяны.
Результаты теста класса А: 78, 80, 82, 80, 80. Среднее 80, все значения плотно сгруппированы.
Результаты теста класса Б: 40, 100, 60, 100, 100. Среднее 80, но оценки резко колеблются от неудовлетворительных до идеальных.
Одинаковое среднее — 80. Один класс однороден, другой разделен на отстающих и отличников. Отчет, утверждающий, что оба класса «в среднем набрали 80», стирает эту разницу.
Разброс, измеряемый размахом или стандартным отклонением, показывает, насколько сильно значения варьируются вокруг центра. Среднее без разброса — это лишь половина предложения. Всегда спрашивайте, насколько широко рассеяны данные.
Выборка — это аргумент
Малые выборки шумные; смещённые выборки — ошибочные
Статистика описывает тех, кого именно измерили. Если выборка мала или не репрезентативна, полученное число говорит мало о более широком мире, каким бы точным оно ни казалось.
- Размер выборки: малые выборки сильно колеблются из-за случайности. Подбросьте честную монету 4 раза, и результат «100% орёл» вполне вероятен; подбросьте её 4 000 раз, и результат стабилизируется около 50%. Утверждение о «40%-ном улучшении» на основе данных от 10 человек — это в основном шум.
- Репрезентативность: опрос жителей одного района, одной возрастной группы или пользователей одного сайта не может представлять всех. Выборка должна отражать ту популяцию, которую вы хотите описать.
- Смещение отбора: способ сбора выборки искажает её. Онлайн-опрос охватывает только тех, кто его увидел и решил ответить.
- Смещение выживших: вы измеряете только выживших. Во время Второй мировой войны инженеры изучали вернувшиеся самолёты, чтобы решить, куда добавить броню, и отмечали места с пулевыми пробоинами. Абрахам Вальд указал, что броню нужно было ставить там, где на вернувшихся самолётах НЕ было пробоин, потому что самолёты, получившие попадания в эти места, так и не вернулись, чтобы их учли.
Отсутствующие данные, то есть люди или случаи, которые выбыли, часто важнее тех данных, которые у вас есть.
График — это аргумент, нарисованный чернилами
Четыре способа, как честное число превращается в нечестный график
Правильные данные можно изобразить так, чтобы ввести в заблуждение. Узнайте о четырех самых распространенных визуальных трюках.
- Обрезанная ось: вертикальная ось, которая начинается не с нуля, а выше него. Изменение с 50 на 52 заполняет весь график и выглядит огромным, хотя на самом деле это всего лишь 4%-ное изменение.
- Двойные оси: две линии на двух разных вертикальных шкалах, настроенных так, чтобы они казались движущимися синхронно. Корреляция искусственно создана выбором масштабов, а не обнаружена в данных.
- Выборочный диапазон: выбор только того временного интервала, который поддерживает утверждение. Если начать график температуры или цены с удобного пика или спада, тренд изменится.
- Искажение площади и длины: масштабирование ширины И высоты иконки для отображения удвоенного значения делает ее ПЛОЩАДЬ в четыре раза больше. Глаз считывает площадь, поэтому фигура в 2 раза больше выглядит как в 4 раза.
Каждый из этих трюков использует точные числа. Обман заключается в изображении, а не в данных.
Третья переменная
Две вещи движутся вместе. И что с того?
Когда два показателя растут и падают вместе, они коррелируют. Корреляция — это реальный и полезный факт, но он не доказывает, что одно причиняет другое. С причинностью всегда конкурируют три безобидных объяснения:
- Обратная причинность: возможно, B вызывает A, а не A вызывает B.
- Совпадение: при наличии достаточного количества переменных некоторые из них будут совпадать чисто случайно.
- Конфаундер: скрытая третья переменная влияет на оба показателя.
Классический пример: продажи мороженого коррелируют с числом смертей от утопления. Мороженое никого не топит. Конфаундером здесь является летняя жара, которая одновременно повышает продажи мороженого и количество людей, купающихся в воде.
Прежде чем верить в причинно-следственную связь, ищите конфаундер. Спросите себя, какая третья вещь могла одновременно влиять на оба показателя.
Чек-лист скептика
Одна последняя мысль
Теперь у вас есть чек-лист для любой статистики, которая попадается вам на пути:
1. Мера: какая это средняя величина, и не вводит ли в заблуждение асимметрия или выброс?
2. Разброс: не скрывает ли средняя величина сильную вариацию?
3. Выборка: кого учли, сколько их и кого не хватает?
4. График: с чего начинается ось и не подобран ли диапазон произвольно?
5. Утверждение: не преподносится ли корреляция как причинно-следственная связь, и какой конфандер может её объяснить?
Точные цифры всё равно могут вводить в заблуждение. Число — никогда не весь аргумент. За ним стоят принятые решения.