स्वागत है
बिना धोखा खाए डेटा पढ़ना
संख्याएँ ईमानदार लगती हैं। एक चार्ट प्रमाण जैसा लगता है। लेकिन एक ग्राफ़ तकनीकी रूप से सच होकर भी आपके आँखों को धोखा दे सकता है।
कार्यालय में डैशबोर्ड, समाचारों में चार्ट्स, और स्वचालित रिपोर्ट्स सभी वास्तविक संख्याएँ दिखाते हैं। मुश्किल यह छिपी होती है कि कैसे उन संख्याओं को चित्रित किया जाता है: अक्ष कहाँ से शुरू होता है, कौन सी तारीखें दिखाई जाती हैं, और किसे गिना गया।
आज आप चार जासूसी कौशल सीखेंगे: औसत के पीछे फैलाव (spread) को पढ़ना, भ्रामक ग्राफ़ को पकड़ना, नमूने (sample) पर सवाल उठाना, और न्यायसंगत तुलना की मांग करना।
औसत पूरी कहानी नहीं है
औसत फैलाव को छुपाती है
एक औसत (मीन) सभी मानों को जोड़ती है और उनमें से कितने हैं, इससे विभाजित करती है। यह एक सुंदर संख्या देती है। वह सुंदरता ही खतरा है: एक संख्या यह नहीं दिखा सकती कि डेटा कितना फैला हुआ है।
रेंज (range) सबसे छोटी और सबसे बड़ी मान के बीच की दूरी है। स्प्रेड (spread) यह है कि मान सामान्य तौर पर एक-दूसरे से कितनी दूर हैं।
दो तैराकी के तालाब, प्रत्येक की औसत गहराई 1 मीटर है।
- तालाब A: हर जगह गहराई 1 मीटर है। पैदल पार करने के लिए सुरक्षित।
- तालाब B: कम गहरे हिस्से की गहराई 0.1 मीटर है और गहरे हिस्से की गहराई 3 मीटर है। औसत अभी भी लगभग 1 मीटर है, लेकिन एक छोटे बच्चे को गहरे हिस्से में डूबने का खतरा हो सकता है।
एक ही औसत। बिल्कुल अलग वास्तविकता। औसत ने स्प्रेड को छिपा दिया। जब भी आपको कोई औसत दिखे, पूछें: रेंज क्या है, और मान कितने फैले हुए हैं?
तालाब की समस्या
आपकी बारी
एक रिपोर्ट कहती है: इस पूल की औसत गहराई 1 मीटर है, इसलिए यह छोटे बच्चों के लिए सुरक्षित है।
ग्राफ़ झूठ बोलने के तीन तरीके
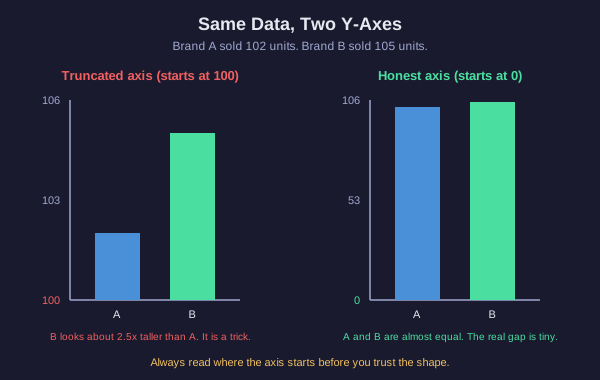
एक चार्ट सच हो सकता है और फिर भी झूठ बोल सकता है
एक ग्राफ़ सही संख्याएँ दिखा सकता है और फिर भी आपको भ्रमित कर सकता है। तीन सबसे आम चालें:
1. कटता हुआ (ज़ूम किया हुआ) y-अक्ष। एक ईमानदार बार चार्ट अपने y-अक्ष को शून्य से शुरू करता है। एक भ्रामक ग्राफ़ इसे बीच से शुरू करता है, उदाहरण के लिए 100 से। चित्र को देखें: ब्रांड A ने 102 और ब्रांड B ने 105 इकाइयाँ बेचीं, जो केवल 3 इकाइयों का अंतर है। जब अक्ष 100 से शुरू होता है, तो ब्रांड B का बार लगभग 2.5 गुना ऊँचा लगता है। अक्ष को 0 से शुरू करें और बार लगभग बराबर होंगे। डेटा कभी नहीं बदला। केवल बेसलाइन बदली गई।
2. चुनिंदा समय सीमा (Cherry-picked time range)। केवल उस तारीखों का हिस्सा दिखाएं जो आपकी कहानी का समर्थन करता है। एक ऐसा स्टॉक जो पूरे वर्ष गिरा, यदि आप केवल एक अच्छे महीने का चार्ट दिखाएं, तो वह बहुत अच्छा दिखता है। पूछें: चार्ट ठीक उन तारीखों पर क्यों शुरू और समाप्त होता है?
3. बदली हुई या असंगत स्केल (Changed or inconsistent scale)। संख्याओं के बीच असमान अंतर, या एक ऐसा स्केल जो बीच में बदल जाता है, परिवर्तनों को खिंचा या सिकोड़ा दिखा सकता है। एक ही संख्याओं का उपयोग करके एक रेखा को क्लिफ (गिरती चट्टान) या हल्की पहाड़ी की तरह बनाया जा सकता है।
डिटेक्टिव का तरीका हमेशा वही होता है: आकार पर भरोसा करने से पहले एक्सिस (axis) और रेंज (range) को पढ़ें।
यह ग्राफ़ भ्रामक क्यों है?
चाल को पहचानें
एक न्यूज़ चार्ट में दो बार दिखाए गए हैं: पिछले महीने का अपराध संख्या 500 थी, इस महीने की 515 है। लेकिन य-एक्सिस (y-axis) 0 की बजाय 495 से शुरू होती है। स्क्रीन पर, इस महीने का बार पिछले महीने के बार की तुलना में लगभग चार गुना ऊंचा दिखता है। हेडलाइन पढ़ने को मिलती है: अपराध में विस्फोट!
कुछ लोगों से पूछना बनाम हर किसी से पूछना
नमूना: समग्र का प्रतिनिधित्व करने वाले कुछ लोग
अक्सर आप सभी से पूछ नहीं सकते, इसलिए आप एक नमूने (sample) से पूछते हैं: एक छोटा समूह जो समूह के समग्र (जिसे जनसंख्या कहा जाता है) का प्रतिनिधित्व करने के लिए बनाया गया है।
नमूना तभी समग्र के बारे में सच बताता है जब वह समग्र का प्रतिनिधित्व करता है। जब ऐसा नहीं होता है, तो वह एक पक्षपाती नमूना (biased sample) होता है।
पक्षपाती नमूनों के उदाहरण:
- एक वेबसाइट अपने ही विज़िटरों से पूछती है कि वे वेबसाइट को पसंद करते हैं या नहीं। वे लोग जो इसे नफरत करते हैं, वे पहले ही चले गए हैं।
- स्कूल के खाने के बारे में एक सर्वेक्षण केवल उन छात्रों को दिया जाता है जो पिज़्ज़ा की कतार से बाहर निकल रहे हैं।
- एक पोल (मतदान) केवल कार्यदिवस के दोपहर के समय चलाया जाता है, जिससे उन सभी को छोड़ दिया जाता है जो काम पर होते हैं।
दो प्रश्न अधिकांश पूर्वाग्रह (bias) को उजागर करते हैं: कौन बाहर रह गया? और *क्या बाहर रह गए लोगों के जवाब अलग होते? एक बड़ा नमूना (sample) पूर्वाग्रह को ठीक नहीं करता; एक लाख गलत लोगों का सर्वेक्षण भी गलत ही होता है।
सर्वेक्षण की समस्या
आपकी बारी
एक जिम ने पोस्ट किया: हमने शनिवार की सुबह हमारे जिम में 200 लोगों से सर्वेक्षण किया। 95 प्रतिशत कहते हैं कि व्यस्त सप्ताह में व्यायाम करना आसान है। इसलिए लगभग हर किसी के लिए व्यायाम करना आसान है।
एक ही इकाइयाँ, एक ही आधार
तुलना को निष्पक्ष क्या बनाता है
पिछला डिटेक्टिव मूव सबसे सरल है: जब दो चीज़ों की तुलना की जाती है, तो जाँचें कि तुलना निष्पक्ष है।
एक निष्पक्ष तुलना दोनों पक्षों के लिए एक ही इकाइयाँ और एक ही आधार का उपयोग करती है।
अन्यायपूर्ण तुलनाएँ अक्सर सामने-सामने छुपी होती हैं:
- अलग-अलग इकाइयाँ। हमारे फोन की बैटरी 5000 की है, उनके फोन की सिर्फ 12 की! एक संख्या मिलीएम्पियर-घंटा में है, दूसरी घंटों में। इन्हें तुलना नहीं किया जा सकता।
- अलग-अलग आधार। शहर A में 50 अपराध हुए, शहर B में 200, इसलिए शहर B बहुत अधिक खतरनाक है। लेकिन शहर B में 20 गुना अधिक लोग हैं। प्रति व्यक्ति आधार पर, शहर A की स्थिति बदतर है। कच्चे कुल (raw totals) की बजाय दरों (प्रति 1000 लोगों के हिसाब से) की तुलना करें।
- अलग-अलग समय अवधि। एक चीज़ का पूरा साल दूसरी चीज़ के एक महीने के साथ तुलना करना न्यायपूर्ण दौड़ नहीं है।
किसी भी तुलना को स्वीकार करने से पहले, पूछें: क्या इकाइयाँ एक जैसी हैं? क्या आधार एक जैसा है? क्या समय अवधि एक जैसी है?
शहर की समस्या
आपकी बारी
एक पोस्ट का दावा है: शहर A ने पिछले साल 50 चोरी की रिपोर्ट की। शहर B ने पिछले साल 200 चोरी की रिपोर्ट की। शहर B चार गुना अधिक खतरनाक है। शहर A में 10,000 लोग हैं। शहर B में 500,000 लोग हैं।
आप क्या याद रखेंगे?
एक अंतिम विचार
संख्याएँ और चार्ट प्रकृति से झूठ नहीं हैं। वे उपकरण हैं, और जैसे किसी भी उपकरण को अच्छे या बुरे इरादे से इस्तेमाल किया जा सकता है, वैसे ही इनका भी इस्तेमाल अच्छे या बुरे इरादे से किया जा सकता है। एक डैशबोर्ड, एक न्यूज़ ग्राफिक, और एक स्वचालित रिपोर्ट सभी तकनीकी रूप से सच हो सकते हैं और फिर भी आपको एक गलत चित्र प्रस्तुत कर सकते हैं।
अब आपके पास चार जासूसी कौशल हैं: औसत के पीछे स्प्रेड (विचरण) को पढ़ें, जाँचें कि ग्राफ का अक्ष कहाँ से शुरू होता है और यह कौन सा अंतराल दिखा रहा है, सवाल करें कि नमूने (sample) में कौन शामिल है, और किसी भी तुलना में एक ही इकाइयाँ और बेसलाइन की माँग करें।
केवल आकार नहीं, बल्कि अक्ष और नमूने (sample) को पढ़ें।